
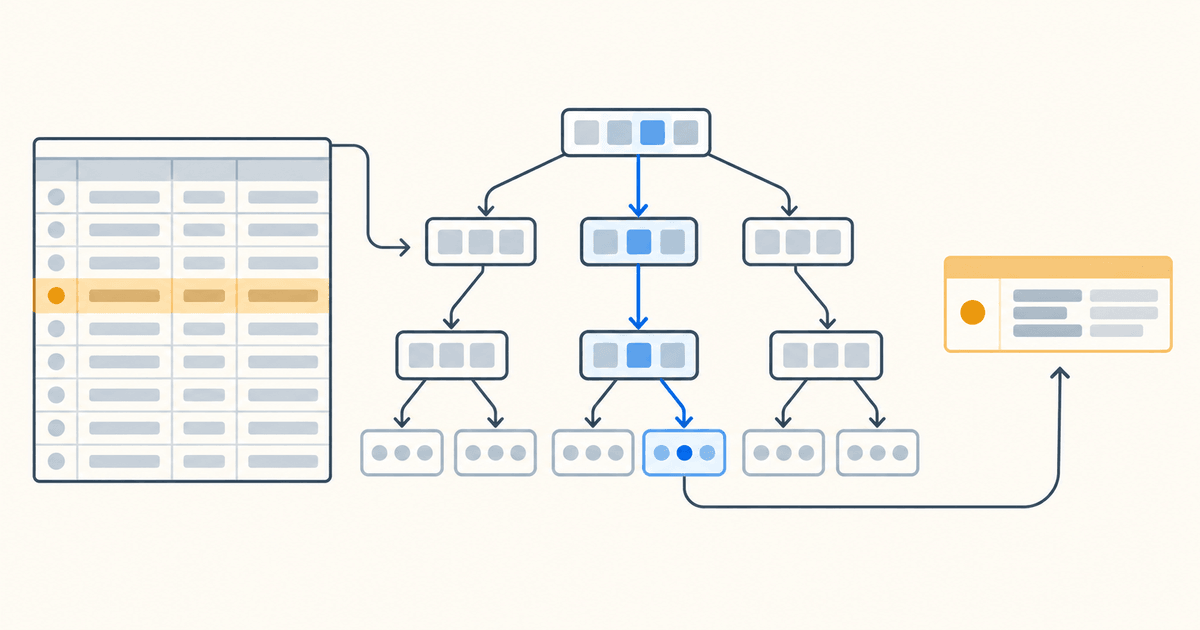
인덱스는 ASC로 만들어도 DESC 방향으로 순회 가능
- DESC 정렬은 ASC 인덱스를 역순으로 스캔할 수 있다. 다만 ASC 스캔 대비 오버헤드가 있을 수 있다
- MySQL 5.x에서는
CREATE INDEX ... DESC를 써도 실제 저장은 ASC였고 8.x부터는 실제로 DESC 인덱스를 만들 수 있다
관련 링크:
(A, B, C) 복합 인덱스는 leftmost prefix 규칙으로 (A)와 (A, B)를 포함
WHERE A=? AND B=?또는ORDER BY A, B같은 쿼리는 별도 인덱스 없이 커버된다WHERE B=?처럼 where 조건을 주는 경우에는 `(A, B, C) 인덱스를 사용 불가능하니 별도로 인덱스를 만들어야 한다
EXPLAIN과 EXPLAIN ANALYZE로 쿼리 플랜을 보거나 쿼리 플랜 대비 실제 쿼리 실행 결과 비교
EXPLAIN FORMAT=TREE
SELECT first_name, last_name, SUM(amount) AS total
FROM staff INNER JOIN payment
  ON staff.staff_id = payment.staff_id
     AND
     payment_date LIKE '2005-08%'
GROUP BY first_name, last_name;

-> Table scan on <temporary>
    -> Aggregate using temporary table
        -> Nested loop inner join  (cost=1757.30 rows=1787)
            -> Table scan on staff  (cost=3.20 rows=2)
            -> Filter: (payment.payment_date like '2005-08%')  (cost=117.43 rows=894)
-> Index lookup on payment using idx_fk_staff_id (staff_id=staff.staff_id) (cost=117.43 rows=8043)- 위와 같이
EXPLAIN명령을 통해 어떤 쿼리 플랜이 적용되는지 확인 할 수 있다
EXPLAIN ANALYZE
SELECT first_name, last_name, SUM(amount) AS total
FROM staff INNER JOIN payment
  ON staff.staff_id = payment.staff_id
     AND
     payment_date LIKE '2005-08%'
GROUP BY first_name, last_name;

-> Table scan on <temporary>  (actual time=0.001..0.001 rows=2 loops=1)
    -> Aggregate using temporary table  (actual time=58.104..58.104 rows=2 loops=1)
        -> Nested loop inner join  (cost=1757.30 rows=1787) (actual time=0.816..46.135 rows=5687 loops=1)
            -> Table scan on staff  (cost=3.20 rows=2) (actual time=0.047..0.051 rows=2 loops=1)
            -> Filter: (payment.payment_date like '2005-08%')  (cost=117.43 rows=894) (actual time=0.464..22.767 rows=2844 loops=2)
                -> Index lookup on payment using idx_fk_staff_id (staff_id=staff.staff_id)  (cost=117.43 rows=8043) (actual time=0.450..19.988 rows=8024 loops=2)
EXPLAIN ANALYZE는 쿼리를 실제 실행하여 예상 시간과 실제 시간을 비교할 수 있다(8.x부터)
관련 링크:
필요한 경우 INDEX HINT 사용하여 쿼리 플랜 대신 지정한 인덱스를 사용 / 무시
SELECT
    O.order_id, O.customer_id
FROM
    orders O
FORCE INDEX (pk_orders) -- pk_orders 인덱스를 반드시 사용하도록 강제
WHERE
O.order_date > DATE_SUB(NOW(), INTERVAL 7 DAY);- 위처럼
FORCE INDEX,IGNORE INDEX,USE INDEX등의 문구를 사용하여 인덱스를 강제로 사용하게 하거나 무시, 혹은 사용을 유도할 수 있다 - JPA는
QueryHintAnnotation, Querydsl-SQL의 경우forceIndex/useIndex메소드 등을 통해 인덱스 힌트를 줄 수 있다 - 쿼리 플랜이 부정확하여 slow query 가 발생하는 경우에만 제한적으로 사용한다
clustered index는 하나만 존재. 그 외 인덱스는 모두 secondary index
- PK가 존재하면 PK가 clustered index, PK가 없으면 모든 컬럼이 NOT NULL로 되어 있는 유니크 인덱스를 사용, 이마저도 없으면 GEN_CLUST_INDEX 라는 숨김 처리 인덱스를 사용
- 모든 secondary index leaf가 clusterd-index 값을 저장하고 이 값을 통해 double-read가 발생한다(secondary → clustered)
- clustered-index의 사이즈가 큰 경우 모든 secondary index의 크기도 커진다
- 필요한 컬럼이 인덱스에 모두 있으면 covering index가 되어 secondary index여도 clustered index를 사용하지 않고 쿼리 결과를 계산할 수 있다
관련 링크:
cardinality가 낮은 컬럼은 인덱스로 사용하기에 비효율적임
Y/N나 상태 코드 같이 cardinality가 낮은 컬럼은 인덱스에 넣는 것이 오히려 더 성능에 안 좋을 수 있다